Готовая презентация · 6 слайдов

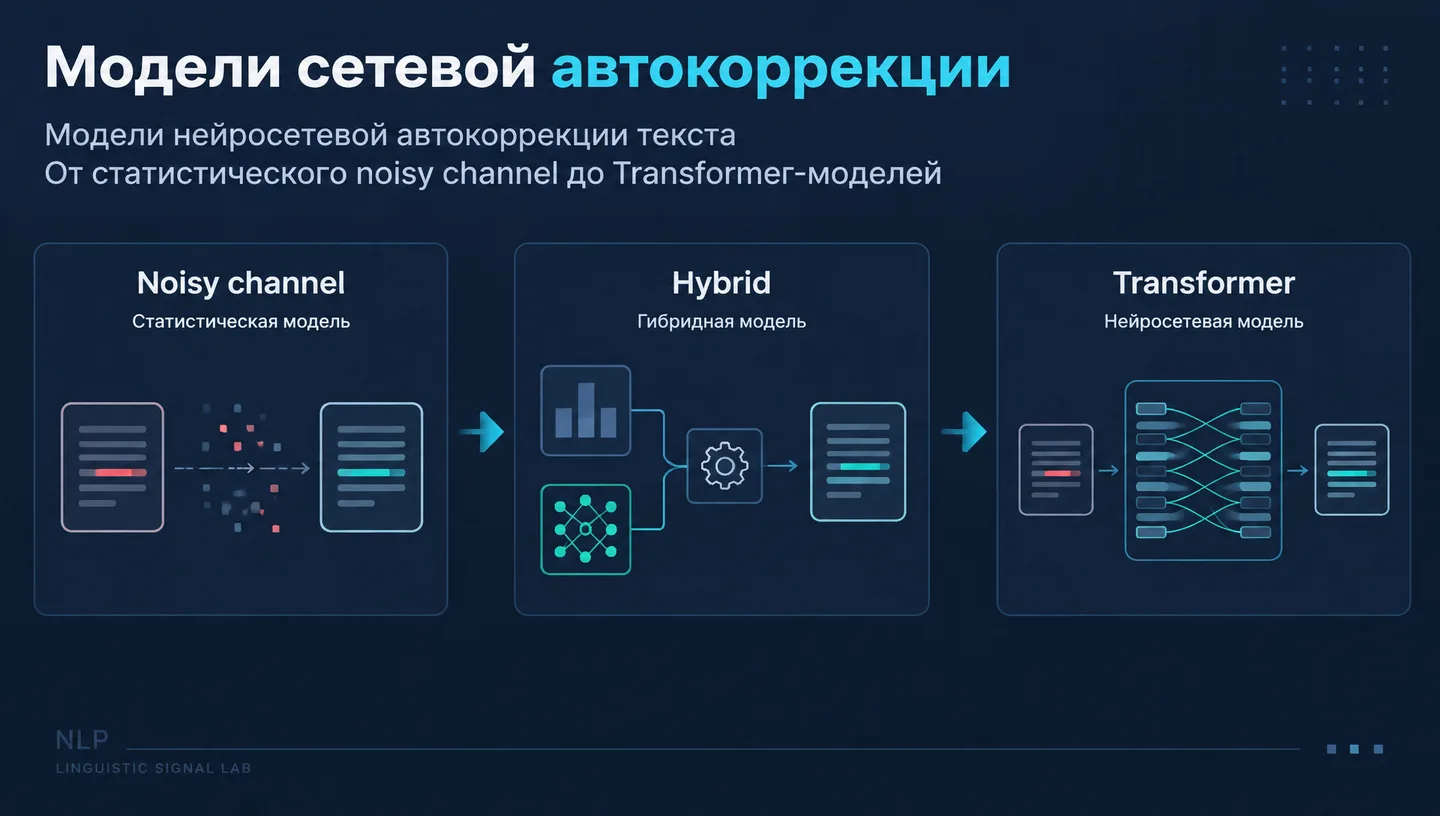
Модели сетевой автокоррекции

Модели нейросетевой автокоррекции текста От статистического noisy channel до Transformer-моделей Noisy channel — Статистическая модель Hybrid — Гибридная модель Transformer — Нейросетевая модель
Готовая презентация

6 слайдов · PDF и PowerPoint

Бесплатно после входа.

Собрать свою презентацию по этой теме →

В этой презентации

Слайды и пояснения

Показать план

План презентации

  1. Модели сетевой автокоррекции
  2. Что именно исправляет модель
  3. Базовая идея: noisy channel
  4. Статистическая модель
  5. Как выбирается кандидат
  6. Гибридная модель для русского языка
1. Модели сетевой автокоррекции

Модели нейросетевой автокоррекции текста От статистического noisy channel до Transformer-моделей Noisy channel — Статистическая модель Hybrid — Гибридная модель Transformer — Нейросетевая модель

Подсказка для выступления

Уточни, что под «сетевой автокоррекцией» здесь понимается нейросетевая автокоррекция текста. Покажи, что далее будут рассмотрены и статистические модели как основа современных систем.

2. Что именно исправляет модель

Что именно исправляет модель

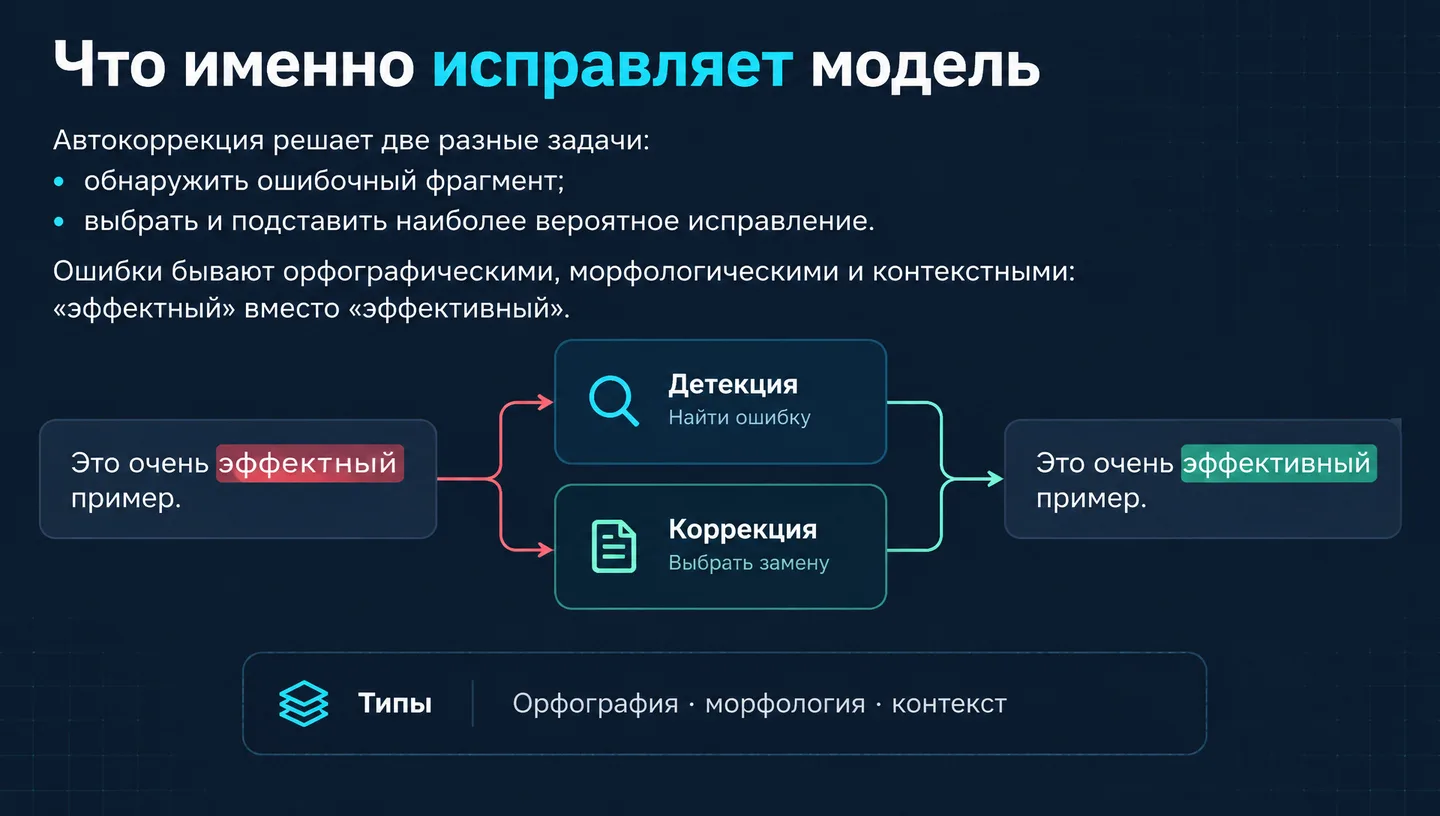
Автокоррекция решает две разные задачи: • обнаружить ошибочный фрагмент; • выбрать и подставить наиболее вероятное исправление. Ошибки бывают орфографическими, морфологическими и контекстными: «эффектный» вместо «эффективный». Детекция — Найти ошибку Коррекция — Выбрать замену Типы — Орфография · морфология · контекст

Подсказка для выступления

Приведи пример с ошибкой внутри контекста: система должна не только найти слово, похожее по написанию, но и понять его роль в предложении.

3. Базовая идея: noisy channel

Базовая идея: noisy channel

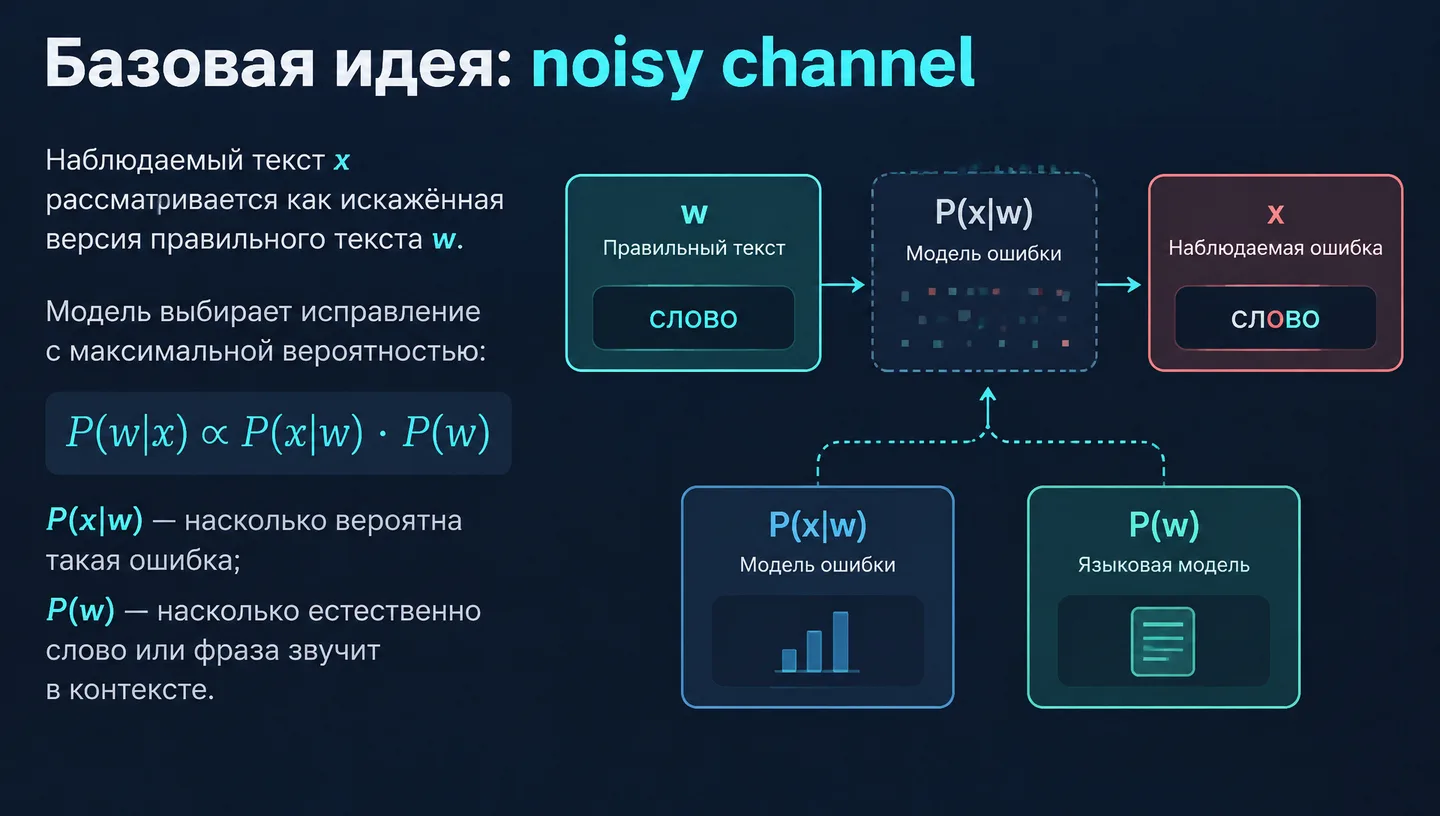
Наблюдаемый текст x рассматривается как искажённая версия правильного текста w. Модель выбирает исправление с максимальной вероятностью: P(w|x) ∝ P(x|w) · P(w) P(x|w) — насколько вероятна такая ошибка; P(w) — насколько естественно слово или фраза звучит в контексте. w — Правильный текст x — Наблюдаемая ошибка P(x|w) — Модель ошибки P(w) — Языковая модель

Подсказка для выступления

Объясни формулу как байесовский выбор: хорошее исправление должно быть одновременно похожим на источник ошибки и естественным для языка.

4. Статистическая модель

Статистическая модель

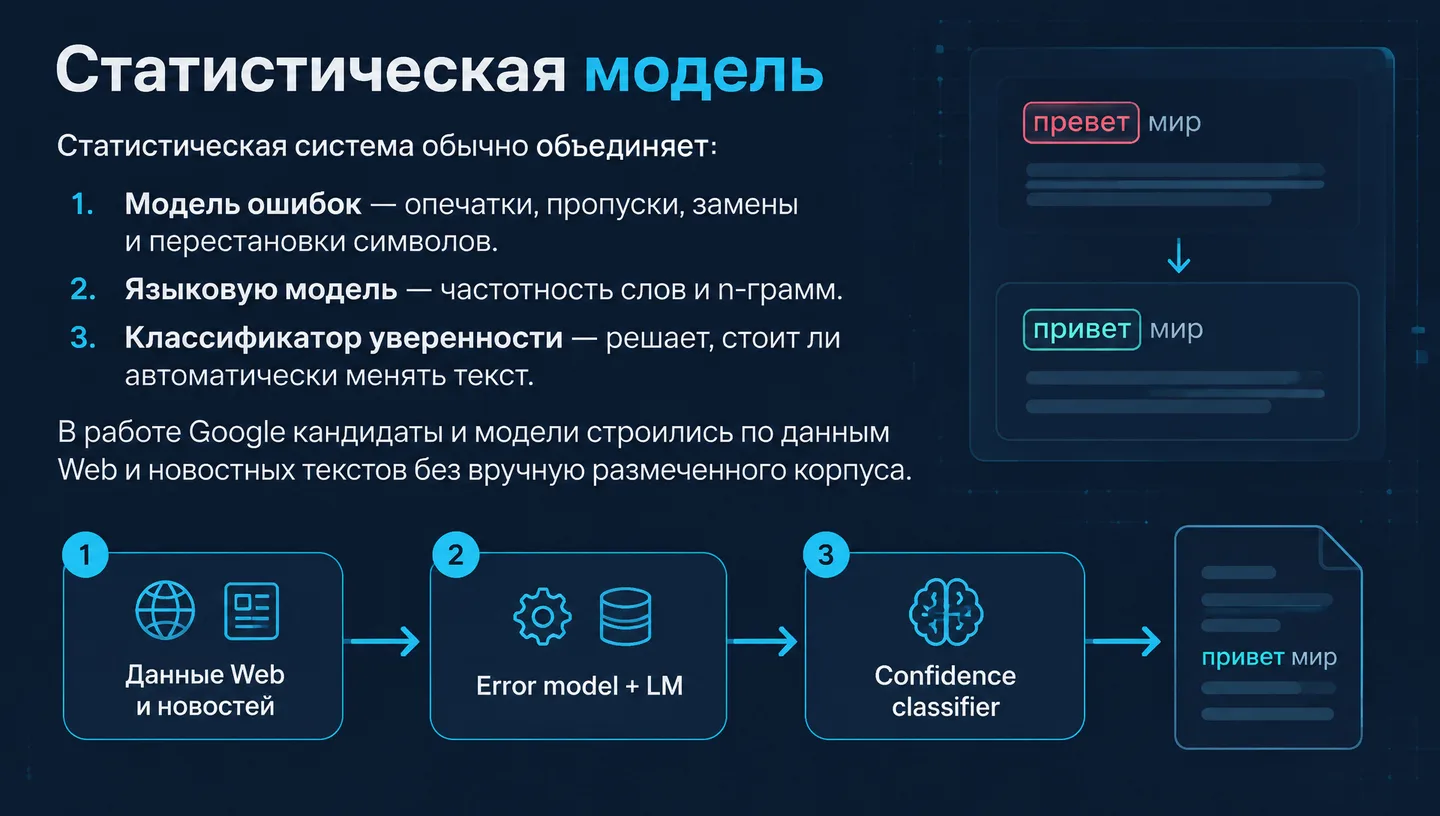
Статистическая система обычно объединяет: 1. Модель ошибок — опечатки, пропуски, замены и перестановки символов. 2. Языковую модель — частотность слов и n-грамм. 3. Классификатор уверенности — решает, стоит ли автоматически менять текст. В работе Google кандидаты и модели строились по данным Web и новостных текстов без вручную размеченного корпуса. 1 — Данные Web и новостей 2 — Error model + LM 3 — Confidence classifier

Подсказка для выступления

Отметь важную особенность описанной системы Google: она использует Web как большой шумный корпус и не требует вручную составленного словаря правильных слов.

5. Как выбирается кандидат

Как выбирается кандидат

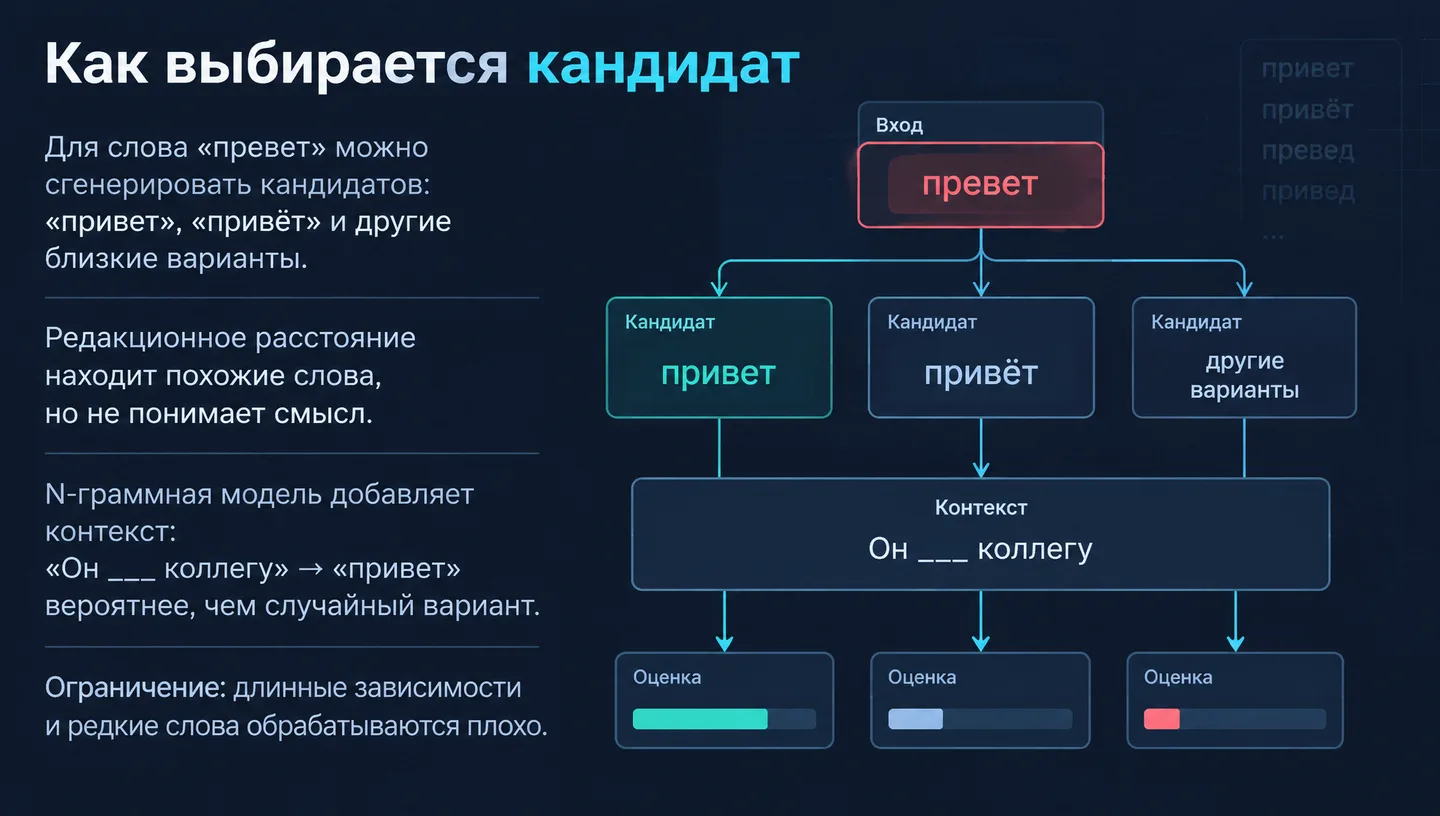
Для слова «превет» можно сгенерировать кандидатов: «привет», «привёт» и другие близкие варианты. Редакционное расстояние находит похожие слова, но не понимает смысл. N-граммная модель добавляет контекст: «Он ___ коллегу» → «привет» вероятнее, чем случайный вариант. Ограничение: длинные зависимости и редкие слова обрабатываются плохо. Вход — превет Кандидат — привет Контекст — Он ___ коллегу

Подсказка для выступления

Поясни, что расстояние редактирования создаёт множество кандидатов, а языковая модель ранжирует их в контексте. Обрати внимание на проблему омонимичных замен и длинных зависимостей.

6. Гибридная модель для русского языка

Гибридная модель для русского языка

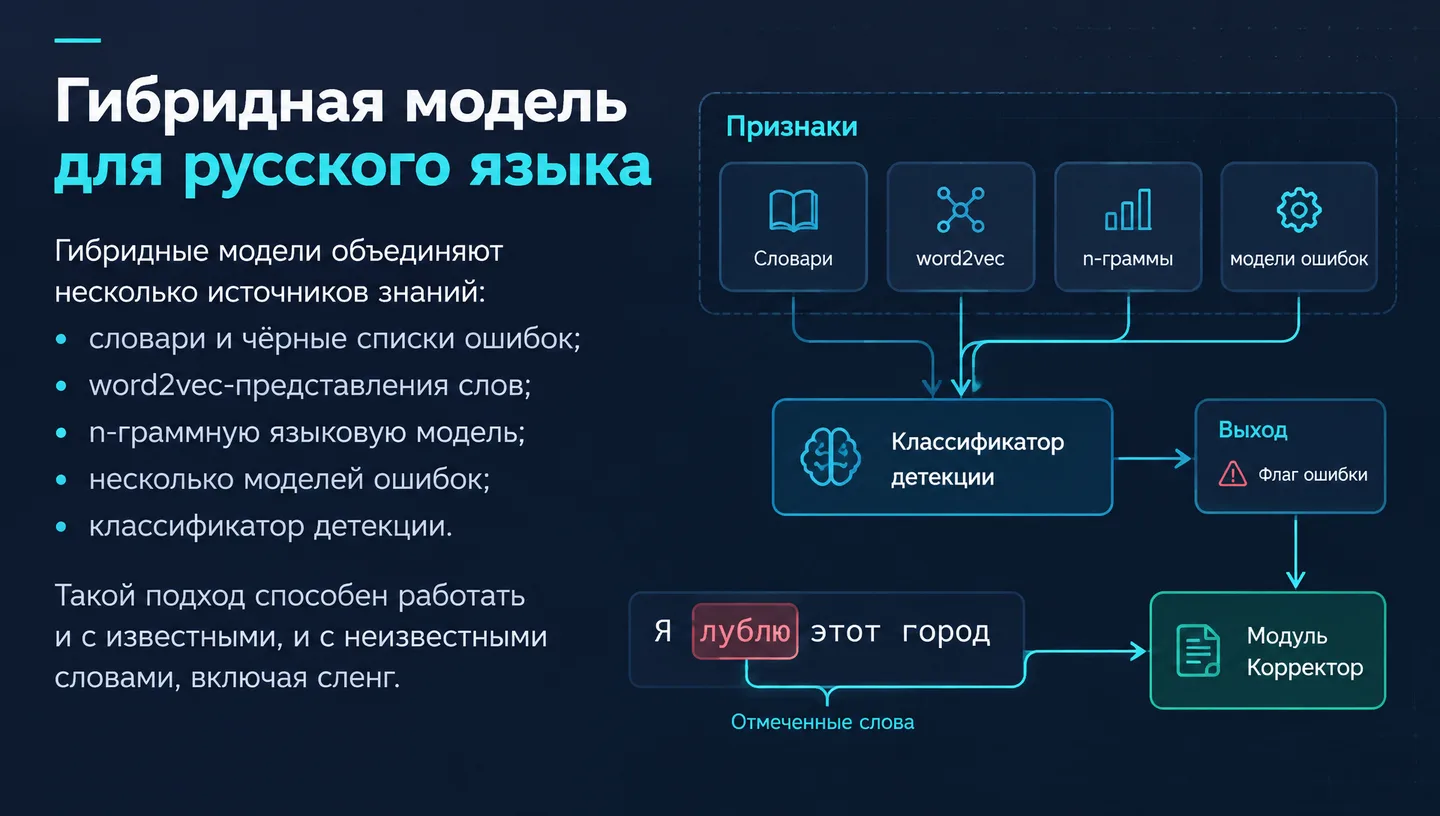
Гибридные модели объединяют несколько источников знаний: • словари и чёрные списки ошибок; • word2vec-представления слов; • n-граммную языковую модель; • несколько моделей ошибок; • классификатор детекции. Такой подход способен работать и с известными, и с неизвестными словами, включая сленг. Признаки — Словари · word2vec · n-граммы · модели ошибок Выход — Флаг ошибки Модуль — Корректор

Подсказка для выступления

Подчеркни, что гибридный подход не полагается на один источник признаков. Сочетание моделей особенно полезно при неизвестных словах и сленге.

Источники